(서울=뉴스1) 나연준 기자 = 미국의 첨단 반도체 수출통제로 엔비디아의 최신 인공지능(AI) 칩 확보에 제약을 받는 중국이 '초대형 클러스터'에서 돌파구를 찾고 있다. 개별 AI 칩의 성능만으로 엔비디아를 따라잡기보다 자체 AI 프로세서를 최대 100만 개 규모로 연결해 하나의 거대한 컴퓨터처럼 작동시키겠다는 전략이다.
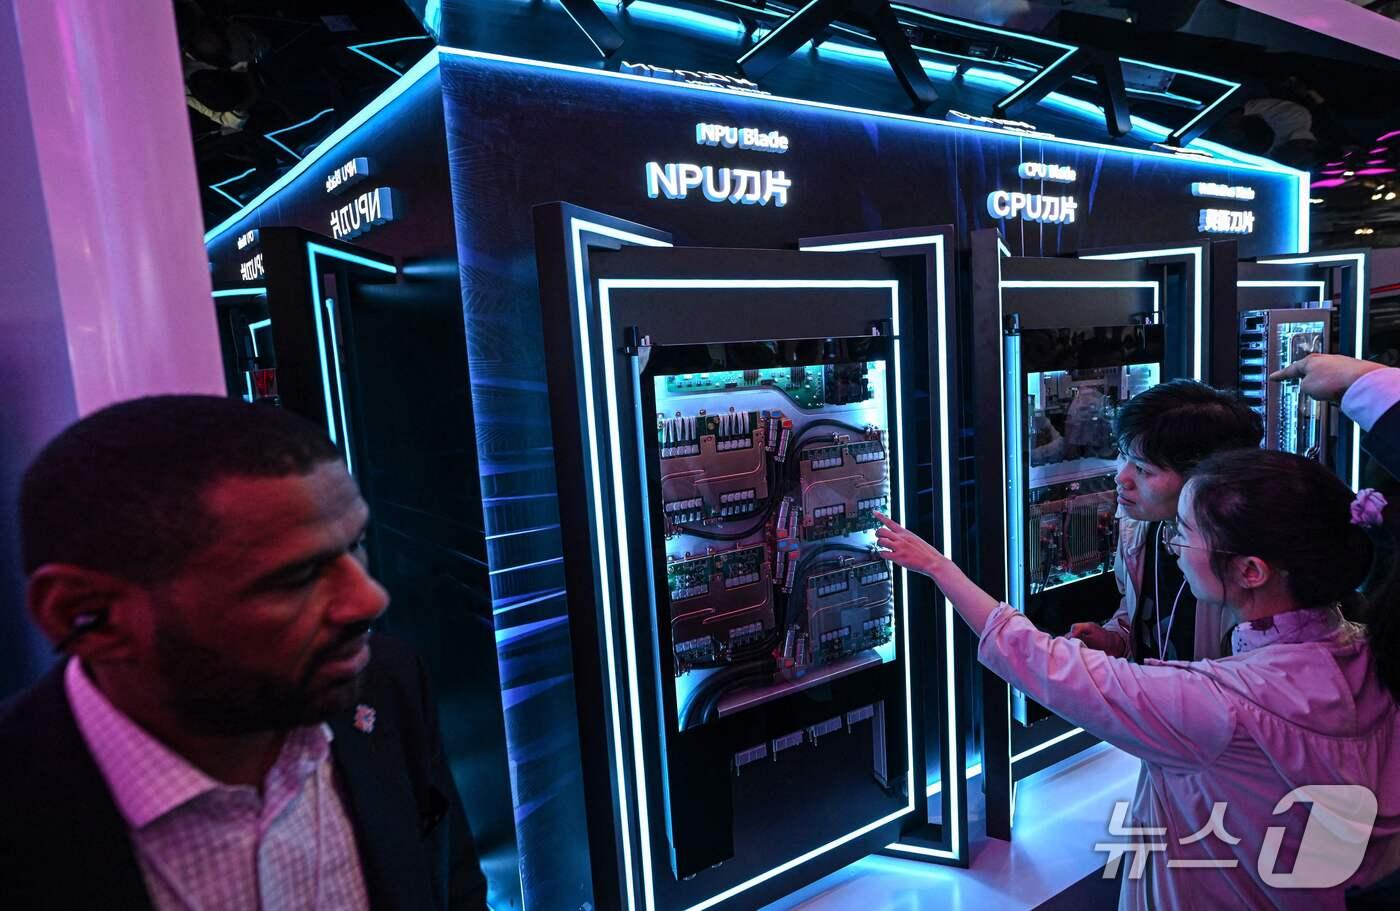
20일 업계에 따르면 화웨이는 지난 17일 중국 상하이에서 열린 '화웨이 커넥트 2026'에서 차세대 AI 칩과 컴퓨팅 인프라 로드맵을 공개했다.
화웨이는 차세대 AI 칩 '어센드 960DT'를 2027년 1분기, '어센드 960PR'을 같은 해 3분기에 출시할 계획이다. 2028년과 2029년에는 각각 어센드 970과 980을 내놓으며 매년 한 세대씩 AI 칩을 고도화한다.
주목할 부분은 개별 칩의 성능보다 이를 연결하는 방식이다. 화웨이는 최대 100만 개의 프로세서를 하나의 컴퓨터처럼 작동시키는 '피어리움'(Peerium) 컴퓨팅 아키텍처를 공개했다.
AI 모델을 학습하거나 구동하는 연산은 여러 AI 프로세서에 작업을 나눠 동시에 처리할 수 있다. 개별 칩의 성능이 상대적으로 떨어지더라도 많은 칩을 효율적으로 연결하면 클러스터 전체의 연산 능력을 높여 성능 격차를 일정 부분 보완할 수 있다.
핵심은 자체 고속 인터커넥트 기술 '유니파이드버스'(UnifiedBus)다. CPU와 NPU, 메모리, 저장장치, 네트워크 등을 하나의 프로토콜로 연결해 대규모 AI 연산 과정에서 발생하는 데이터 이동의 병목을 줄이는 방식이다.
칩을 아무리 많이 연결해도 프로세서 사이의 데이터 전송이 느리면 일부 칩은 연산을 마치고도 다른 칩의 작업을 기다려야 한다. 실제 연산에 사용되지 못하는 시간이 늘면서 수십만 개의 칩을 투입한 효과도 떨어진다.
화웨이는 유니파이드버스를 통해 이 같은 통신 병목을 줄이고 더 많은 프로세서를 동시에 활용해 시스템 전체의 연산 성능을 높일 수 있다고 설명했다.
자체 시뮬레이션 결과도 제시했다. 4096개 NPU를 하나의 슈퍼팟(SuperPoD)으로 묶은 뒤 이를 연결해 10만 NPU 규모 클러스터를 구성할 경우, 기존 8개 NPU 단위 서버를 연결해 만든 같은 규모의 클러스터보다 모델 연산 활용률(MFU)이 2.75배 높아진다는 주장이다. 같은 수의 AI 칩을 투입하더라도 연결 구조를 개선하면 실제 AI 연산에 활용되는 컴퓨팅 자원을 늘릴 수 있다는 설명이다.
미국의 수출통제로 엔비디아 최신 AI 칩에 대한 접근이 제한된 상황에서 개별 칩의 성능 격차를 '더 많은 칩'과 '더 효율적인 연결'로 보완하려는 전략인 셈이다.
중국의 이 같은 전략은 미국과의 막대한 AI 투자 격차 속에서 나온다는 점에서도 주목된다.
무디스가 지난 8월 발표한 보고서에 따르면 중국 주요 기술기업의 자본지출은 지난해 650억 달러에서 올해 약 1400억 달러, 내년 1650억 달러로 증가할 전망이다. 반면 미국 6대 하이퍼스케일러의 올해 자본지출은 약 7850억 달러로 중국의 약 5.6배에 달한다. 내년에는 1조 달러에 육박할 것으로 예상된다.
사우스차이나모닝포스트(SCMP)는 투자액 격차만큼 실제 AI 인프라 격차가 벌어진 것은 아니라고 분석했다. 중국이 상대적으로 낮은 데이터센터 건설·운영 비용과 정책 지원, 저렴한 전력 등을 바탕으로 적은 투자로도 AI 컴퓨팅 인프라를 빠르게 확대하고 있다는 설명이다.
최첨단 칩과 투자 규모의 열세를 데이터센터 구축 비용과 대규모 시스템 운용 효율로 일부 만회하려는 전략은 화웨이의 초대형 클러스터 구상에서도 드러난다.
막대한 자본력에 더해 미국은 엔비디아의 최첨단 GPU를 확보할 수 있다는 점에서도 우위에 있다. 중국으로서는 미국과 같은 방식으로 경쟁하기보다 제한된 조건에서 확보한 컴퓨팅 자원을 얼마나 효율적으로 활용하느냐가 중요해진 셈이다.
엔비디아도 GPU 자체의 성능만으로 시장을 장악한 것은 아니다. NVLink 등 고속 인터커넥트와 네트워킹, CUDA 소프트웨어 생태계를 결합해 수많은 GPU를 하나의 컴퓨팅 시스템처럼 운영하는 전략을 강화해 왔다.
이경선 정보통신정책연구원(KISDI) 연구위원은 "하드웨어도 중요하지만 이를 실제로 쓸 수 있게 해주는 소프트웨어가 중요하다"며 엔비디아 역시 CUDA 등 하드웨어와 소프트웨어를 유기적으로 결합해 경쟁력을 확보했다고 설명했다.
중국도 엔비디아 칩을 단순히 대체하는 데서 나아가 인터커넥트와 네트워크, 소프트웨어를 아우르는 자체 AI 컴퓨팅 풀스택 구축에 나서고 있다. 미중 AI 반도체 경쟁도 개별 칩의 성능뿐 아니라 수많은 칩을 얼마나 효율적으로 연결하고 활용하느냐를 겨루는 '시스템 경쟁'으로 확대되고 있다.
yjra@news1.kr