(서울=뉴스1) 김민석 기자 = 노타(486990)가 AMD 프로세서의 그래픽처리장치(GPU)와 신경망처리장치(NPU)를 활용해 AI 답변 완료 시간을 최대 52% 줄였다. 모델 크기를 줄이는 경량화를 넘어 연산 배분과 메모리 사용 방식까지 개선해 같은 하드웨어의 실행 효율을 높였다.
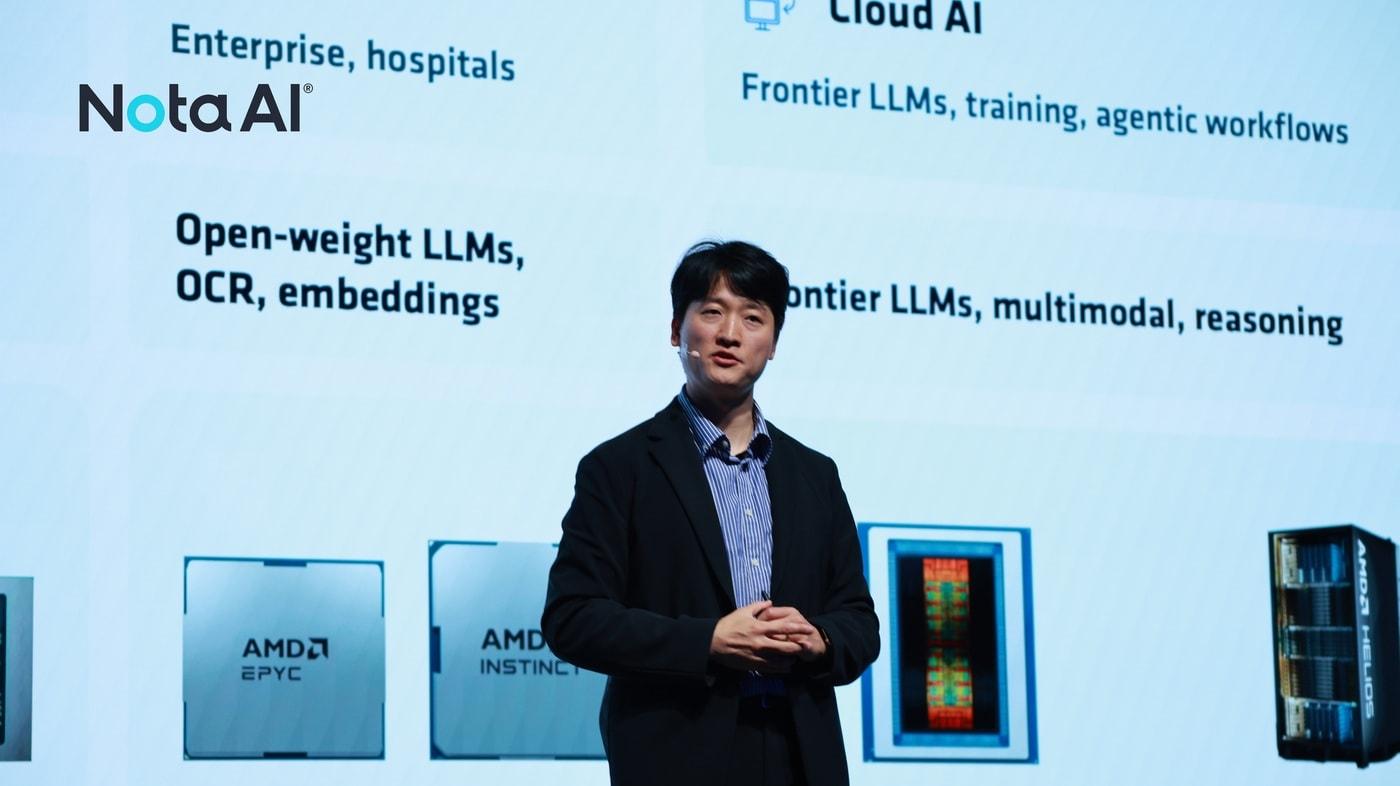
노타는 이달 4일 서울에서 열린 'AMD 어드밴싱 AI 월드 투어 서울 2026'에서 이 같은 추론 최적화 성과를 발표했다고 9일 밝혔다.
AMD '라이젠 AI Max+ 395' 기반 자체 시험에서 큐웬3-8B 모델의 전체 답변 완료 시간은 기존 AMD GPU·NPU 하이브리드 실행 환경보다 28~52% 단축됐다. 토큰당 에너지 소비는 31%, 토큰당 생성 시간은 41~46% 줄었다.
핵심은 AI 추론 과정을 장치 특성에 맞게 나누고 모델 가중치를 공유하는 것이다. 입력 정보를 처리하는 '프리필'(Prefill)은 NPU가, 답변을 순차적으로 생성하는 '디코드'는 GPU가 맡는다.
이 같은 역할 분담은 AMD가 기존에 제시한 하이브리드 추론 방식이다. AMD는 연산량이 많은 프리필에는 NPU가, 메모리 대역폭의 영향을 많이 받는 디코드에는 내장 GPU가 적합하다고 설명한다. 노타는 두 장치를 함께 쓰는 기존 구조에서 실행 효율을 추가로 개선했다.
노타는 행사에서 이 같은 단일 모델 공유 구조와 실행 소프트웨어 개선 사례를 공개했다.
노타는 자체 AI 모델 최적화 플랫폼 '넷츠프레소'에는 AI 에이전트를 적용했다. 에이전트가 모델과 하드웨어 특성을 분석해 최적화 전략을 세운 뒤 실제 장치에서 성능을 검증하며 개선하는 방식이다. 최적화 범위도 모델 경량화에서 추론 실행 소프트웨어인 런타임과 GPU 연산을 수행하는 커널까지 넓혔다.
AMD 라이젠 AI 환경에서 라마(Llama), 큐웬(Qwen), 파이(Phi), 미스트랄(Mistral) 등 다양한 언어모델을 대상으로 한 시험 결과도 공개했다. 기존 AMD 하이브리드 실행 환경보다 메모리 사용량을 11~32% 줄였고 NPU 단독 실행 대비 답변 생성 속도는 2.5~3.8배 높였다고 회사 측은 설명했다.
노타는 이번 성과를 바탕으로 AI PC와 로보틱스 등으로 기술 적용 범위를 넓힐 계획이다. 모델부터 추론 실행 환경까지 아우르는 최적화 기술을 공급하고 플랫폼 라이선스 사업도 확대한다.
김태호 노타 최고기술책임자(CTO)는 "에이전틱 AI와 피지컬 AI 시대에는 AI 모델 자체의 성능뿐 아니라 GPU와 NPU 등 다양한 컴퓨팅 자원을 얼마나 효율적으로 활용하느냐가 실제 서비스의 성능과 운영 효율을 결정한다"며 "글로벌 반도체 생태계와의 협력을 기반으로 AI 실행과 운영 최적화 기술의 적용 범위를 넓히고 고객의 컴퓨팅 효율을 높이는 사업을 확대해 나가겠다"고 말했다.
ideaed@news1.kr